jevbooks 独立教程 · 更新于
Jev 1.14 于 2026-10-14 发布,官方强调包括多语言在内的质量改进。图片输入同时开放给 1.13 和 1.14;Box 定位题型需要 1.14。Images / Box 仍是实验能力,格式、限制和准确率可能变化。
实测状态(2026-10-22):本站在开始复测时,官方 API 的首个纯文本探测返回 HTTP 451,提示当前地区不可用,因此没有继续发送图片。下面是已检查请求结构的可复现示例,没有成功的图片响应、耗时或准确率成绩;图片中的已知位置也不冒充模型输出。
1. 先固定模型,再记录实际版本
本例明确使用 jev-1.14.0。10 月 22 日抓取的官方模型文档仍写 jev-latest → 1.13、jev-preview → 1.14;别名可变化,不能按发布日期推断当前指向。保存每次响应的 model、题目、输入和 usage,之后才能公平比较。
本站旧实验的 p50 约 375 ms 和 Top 10 重合 5/10 来自 2026 年 9 月的 1.13,不能改标为 1.14 成绩。官方多语言改进也不等于中文已追平英语。
2. 下载 PNG 与请求,先确认目标
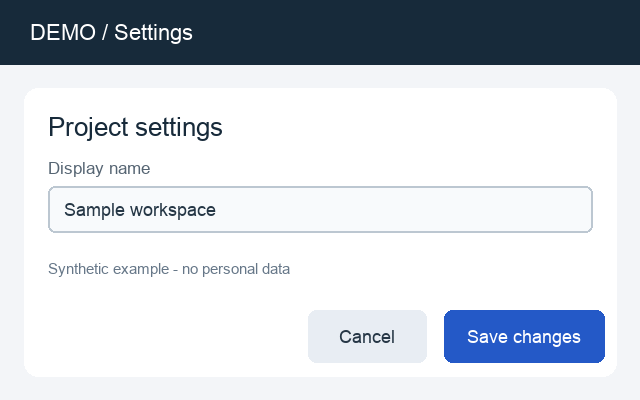
把文件保存在同一目录。Node 脚本需要 Node 22+,不需要安装包;Python 脚本需要 requests。设置环境变量 TYPESAFE_API_KEY 后,运行 node request.mjs 或 python3 request.py。两份脚本读取同一个 request.json,并把成功响应保存为 response.json。
使用 Python 前,先在你的 Python 环境中安装请求依赖:
python3 -m pip install requests
3. 图片进入 assets,不是普通文本
这份请求把唯一图片引用放进 state.screenshot,assets 把引用关联到文件上传字段 screenshot-file。四道题共享同一张图,各自读取 screenshot;不用在每道题中重复放图片引用。
{
  "model": "jev-1.14.0",
  "state": {
    "screenshot": "739c0c20-5636-4ed4-856c-a44ee83f5d20"
  },
  "assets": {
    "739c0c20-5636-4ed4-856c-a44ee83f5d20": {
      "type": "image",
      "part": "screenshot-file"
    }
  },
  "questions": {
    "save_visible": {
      "type": "noul",
      "instructions": "Is a button labeled Save changes visible in `screenshot`?"
    },
    "save_button": {
      "type": "box",
      "instructions": "The entire button labeled Save changes in `screenshot`, including its colored background."
    },
    "delete_visible": {
      "type": "noul",
      "instructions": "Is a button labeled Delete account visible in `screenshot`?"
    },
    "delete_button": {
      "type": "box",
      "instructions": "The entire button labeled Delete account in `screenshot`."
    }
  }
}
也可以直接用 curl。request 必须是 multipart 的第一部分;不要手动写 multipart 的 Content-Type,curl 会生成正确 boundary。每个含图片或 Box 的请求都要携带实验头。
curl --fail-with-body https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "TypeSafe-Danger-Zone-Images: true" \
  -F 'request=@request.json;type=application/json' \
  -F 'screenshot-file=@settings-demo.png;type=image/png' \
  -o response.json
若只能发送 JSON,将资产改为 {"type":"image","format":"png","data_base64":"…"},不要带 data: 前缀,也不要只把 base64 塞进 state。引用会按字符串匹配,使用 UUID 避免误匹配;assets 中每个资产都必须被引用。
官方 SDK 也能创建引用和上传:JavaScript @typesafe-ai/sdk 0.7.0(Node ≥22)、Python typesafe-sdk 0.7.5。新版本默认压缩可能与第三方网关不兼容;本页示例直接访问官方 API。
4. 先看存在概率,再使用 Box 坐标
Noul 与 Box 在同一批并行回答。Box 没有 not-found;即使 Delete account 不存在,也会返回四个边。应用必须先检查 delete_visible.noul,概率不足时丢弃 delete_button.box。Box confidence 不能充当对象存在概率,也不是 IoU。
四边都是 0–1 的相对坐标:left/right 乘图像宽度,top/bottom 乘高度,原点在左上角。下面的代码仅在存在性和定位都通过示例阈值时裁图;阈值需要你自己的样本校准。
裁图代码使用 Pillow(导入名为 PIL),先安装:
python3 -m pip install Pillow
import json
from PIL import Image

response = json.load(open("response.json"))
answers = response["answers"]
visible = answers["save_visible"]["noul"]
answer = answers["save_button"]

# Example thresholds only: calibrate them on your own images.
if visible < 0.8:
    print("No reliable presence signal; ignore the box.")
elif answer["confidence"] < 0.6:
    print("Review or retry on a better crop before using the box.")
else:
    img = Image.open("settings-demo.png")
    width, height = img.size
    b = answer["box"]
    clamp = lambda value: max(0, min(1, value))
    pixels = (
        round(clamp(b["left"]) * width),
        round(clamp(b["top"]) * height),
        round(clamp(b["right"]) * width),
        round(clamp(b["bottom"]) * height),
    )
    if pixels[0] >= pixels[2] or pixels[1] >= pixels[3]:
        raise ValueError("Invalid pixel box after rounding")
    img.crop(pixels).save("save-button.png")

print("served model:", response["model"])
print("input tokens:", response["usage"]["input_tokens"])
一题只找一个目标;多个目标要分题,或先确认 none / one / several,再分区寻找。小目标可先定位大区域,再用更清晰的裁图重问。低 confidence 时可人工复核或适当扩大裁切边界。裁出的图若要再次上传,也必须满足每边至少 280 px。
5. 图片、上下文与成本的边界
| 项目 | 当前规则 |
|---|---|
| 文件 | 仅静态 PNG / JPEG,每张 ≤16 MiB;每边 280–1568 px。 |
| 预处理 | 自行缩放、补边并把像素旋转到正向。API 不自动缩放,也不应用 EXIF 方向。视频需先抽帧。 |
| 体积限制 | 请求体、处理后的图片总量、引用展开后的完整请求分别受 32 MiB 限制;重复引用会重复计入展开量。 |
| 默认上下文 | state + 全部问题 ≤64k token;state + 任意单题 ≤32k。图片 token 也计入。 |
| 实验长上下文 | TypeSafe-Danger-Zone-Long-Context: true — 1.13 / 1.14 两个上限都升至 262k。官方说明更慢、准确率更低;不替代图片实验头。 |
| 价格 | 每百万输入 token $0.042,输出免费;图片与文本同单价。响应 usage.input_tokens 含图片。 |
一次成功请求的输入费用 = usage.input_tokens ÷ 1,000,000 × $0.042。官方尚未给图片 token 估算公式,不承诺固定每图费用。长上下文开关也不会取消 32 MiB 大小限制;先缩小 state、分块,再考虑扩上下文。
下一步与一手来源
- Jev 1.14 发布说明 · 模型、价格和上下文
- Images:资产格式、上传和限制 · Box:坐标与不存在目标
- 从注册与第一条文本请求开始 · 在 n8n 中搭建工单路由
- WorkflowEvals · System One Adapter — 官方可复现评测资源;结果与参考模型的一致率不等于人工真值准确率,复现时固定数据与模型版本。